Extract, transform et load (ETL) constituent la base de presque tous les tableaux de bord de reporting, projets de migration et entrepôts de données actuellement en service. C’est également la partie de la pile de données qui, lorsqu’elle est gérée manuellement, mobilise discrètement le plus de temps de travail des ingénieurs. Ce guide explique le fonctionnement d’un outil ETL, décrit le déroulement concret des trois phases, indique dans quels cas l’approche ELT est préférable, et détaille la manière dont les processus ETL sont mis en place et exploités sur la plateforme X4 BPMS.
Qu'est-ce que l'ETL ?
ETL est l'acronyme de « extract, transform, load » (extraire, transformer, charger) : il s'agit du processus consistant à regrouper les données provenant d'un ou plusieurs systèmes sources dans un système cible. Les données sont extraites, converties au format cible, puis enregistrées dans la destination. L'objectif de cette opération est d'obtenir une vue exploitable et cohérente d'un ensemble de données qui, sans cela, resterait fragmenté entre une douzaine d'applications.
Ce terme est parfois utilisé de manière imprécise pour désigner tout transfert de données. Il convient toutefois d'être précis : l'ETL décrit une séquence spécifique, et c'est précisément cette séquence qui le distingue de l'ELT, de la réplication en continu et de la capture des modifications de données — tous ces concepts étant abordés plus loin.
Fonctionnement du processus ETL
Un processus ETL se déroule en trois phases.
1. Extract
Les données sont sélectionnées dans les systèmes sources et préparées en vue de leur transformation. L'une des étapes de cette phase consiste à définir une fréquence de mise à jour. L'extraction synchrone garantit une actualisation continue des données, mais impose une charge soutenue au réseau et aux systèmes sources. L'extraction asynchrone — qui s'effectue à des moments définis, généralement pendant la nuit — est plus courante précisément parce qu'elle évite d'imposer cette charge pendant les heures de travail.
Dans la pratique, la plupart des organisations finissent par adopter une approche mixte : des chargements complets nocturnes pour les grands ensembles de données de référence, et une extraction événementielle ou incrémentielle pour tout ce qui nécessite une faible latence.
2. Transform
Les données sont adaptées au format et au schéma de la cible. Cette phase ne se limite pas à la conversion des types de fichiers. Elle permet de nettoyer les enregistrements erronés, de supprimer les doublons, de normaliser les formats incohérents, d'appliquer des règles métier et d'agréger les données lorsque la cible attend des agrégats plutôt que des lignes brutes.
La distinction qui importe ici est celle entre la transformation syntaxique — qui consiste à modifier les formats — et la transformation sémantique — qui consiste à harmoniser la signification des données d'un système à l'autre. C'est sur ce second point que les migrations peuvent poser problème. Une fiche client dans l'ancienne base de données CRM et une fiche client dans la nouvelle peuvent partager le même nom de champ tout en ayant des significations différentes.
3. Load
Les données transformées et agrégées sont enregistrées dans la base de données ou l'entrepôt de données cible. Parallèlement à l'écriture, le système consigne les modifications apportées afin que celles-ci restent traçables et que les états antérieurs puissent être restaurés. Dans un environnement réglementé, cette piste d'audit est obligatoire, et c'est l'un des premiers éléments qu'un script créé manuellement a tendance à omettre.
Mettez en place une base de données fiable pour permettre une automatisation pilotée par l'IA et une prise de décision sûre. Téléchargez le livre blanc pour découvrir comment faire de la gouvernance des données une capacité stratégique — et tirer pleinement parti de l'automatisation évolutive et de l'IA.
Qu'est-ce qu'un outil ETL ?
Un outil ETL est un logiciel qui automatise l'ensemble du processus d'extract, transform et load. Il extrait les données brutes des systèmes sources — bases de données, applications cloud, fichiers plats, API —, les convertit dans un format homogène, puis les transfère vers la cible. Il en résulte une structure uniforme et une meilleure qualité des données, deux éléments indispensables aux activités de business intelligence en aval.
Les outils ETL modernes offrent généralement des fonctionnalités de conception visuelle des pipelines, de transformation via SQL ou graphique, de planification et d’orchestration, ainsi que de surveillance de l’intégrité des données. La couche visuelle revêt une importance bien plus grande qu’il n’y paraît : elle fait la différence entre un pipeline que seul son auteur peut maintenir et un pipeline pouvant être exploité par toute une équipe.
Types d'outils ETL
| Type | Points forts | Pour: |
|---|---|---|
| On-Premise | Contrôle total des données, intégration poussée avec les systèmes internes, aucune sortie vers une infrastructure tierce | Organisations soumises à des exigences strictes en matière de sécurité, de souveraineté ou de réglementation |
| Cloud | Évolutivité élastique, coût basé sur la consommation, mise en place rapide | Charges de travail à fort volume dont les données se trouvent déjà dans le cloud |
| Hybride | Le traitement des données sensibles reste local, tandis que la capacité de pointe est assurée dans le cloud | Dans la pratique, la plupart des entreprises, dès lors que leur parc informatique compte plus de quelques systèmes |
| Logiciels libres contre logiciels propriétaires | L'open source offre une grande flexibilité ; les outils propriétaires s'accompagnent généralement d'un support technique, de contrats de niveau de service (SLA) et d'une maintenance. | Cela dépend davantage des capacités techniques internes que du budget |
Pourquoi les entreprises ont besoin d'un outil ETL
Les entreprises puisent dans un grand nombre de sources de données : bases de données opérationnelles, applications cloud, flux de données provenant de partenaires, services de données externes. Sans une approche d'intégration structurée, ces informations restent fragmentées et difficiles à exploiter.
L'automatisation plutôt que le travail manuel. Au lieu d'extraire, de nettoyer et de charger les données manuellement, l'outil exécute le pipeline selon un calendrier ou en réponse à un déclencheur. Cela permet d'éliminer une charge de travail récurrente et, surtout, d'éviter les erreurs humaines qui y sont associées.
Cohérence dès le point d'entrée. Les données provenant de différentes sources présentent des formats, des conventions et des lacunes variés. Grâce aux opérations de déduplication, de normalisation et d'enrichissement effectuées au sein du pipeline, le système cible ne reçoit jamais d'enregistrements qu'il devra nettoyer par la suite.
Traçabilité. Lorsqu’un chiffre figurant dans un rapport semble erroné, la question qui se pose toujours est : d’où provient-il ? Un pipeline maîtrisé peut y répondre ; un script non documenté en est généralement incapable.
C'est également à ce niveau que l'ETL rejoint la gestion des données de référence et le catalogue de données. Le transfert fiable des données est un problème ; s'accorder sur leur signification et sur leur propriété en est un autre, et ces deux aspects se renforcent mutuellement.
Fonctionnalités essentielles d'un outil ETL moderne
- Connecteurs. Adaptateurs prêts à l'emploi pour les bases de données relationnelles, les API, les files d'attente de messages, les plateformes cloud et les formats de fichiers. Toute source ne disposant pas d'un connecteur nécessite un développement sur mesure.
- Nettoyage des données. Détection et correction automatiques des enregistrements incohérents ou non valides, grâce à des règles clairement visibles et non enfouies dans le code.
- Enrichissement et agrégation. Conversion de devises, harmonisation des fuseaux horaires, recherches par rapport à des données de référence, champs dérivés.
- Planification et orchestration. Dépendances entre les tâches, comportement en cas de nouvelle tentative, et réponse claire à la question suivante : que se passe-t-il lorsque la troisième étape sur sept échoue ?
- Surveillance. Une visibilité en temps réel sur les pipelines en cours d'exécution, et non un fichier journal à analyser a posteriori.
- Gestion des erreurs et reprise. Possibilité de relancer un chargement ayant échoué à partir d'un état connu, sans dupliquer les enregistrements.
ETL ou ELT : quel ordre choisir, et à quel moment ?
L'ordre des opérations n'est pas fixe. Dans les environnements de « big data », on parle souvent d'ELT (extraction, chargement, transformation). Les données brutes sont chargées dans la cible sans transformation préalable, formant ainsi un « data lake » composé de formats mixtes, et la transformation n'intervient que lorsqu'une analyse est lancée. Les résultats transformés viennent s'ajouter aux données brutes sans les remplacer.
L'avantage de l'ELT réside dans la rapidité de la migration : les volumes importants sont transférés rapidement, car aucune transformation n'est effectuée lors de l'importation. En contrepartie, les problèmes de qualité sont reportés plutôt que résolus, et le coût de calcul se répercute sur le temps d'exécution des requêtes.
| ETL | ELT | |
|---|---|---|
| La transformation s'opère | Avant le chargement | Après le chargement, au moment de la requête |
| Contenu de la cible | Données nettoyées et harmonisées | Données brutes et ensembles dérivés |
| Idéal pour | Cibles structurées, données réglementées, migrations de systèmes | Grands volumes, analyses exploratoires, lacs de données |
| Risque principal | Le processus devient un goulot d'étranglement à mesure que les règles s'accumulent | Les problèmes de qualité apparaissent tardivement, aux yeux des utilisateurs professionnels |
Parallèlement à ces deux approches, la capture des données modifiées et la réplication en continu sont désormais couramment utilisées lorsque le traitement par lots nocturne s’avère tout simplement trop lent — qu’il s’agisse du statut des commandes, des niveaux de stock ou des relevés de capteurs. Ces techniques ne remplacent pas l’ETL ; elles offrent simplement un profil de latence différent pour un sous-ensemble de flux, et la plupart des environnements exploitent plusieurs modèles en parallèle.
Dans quels contextes utilise-t-on l'ETL ?
- Migration des données vers une nouvelle application ou un référentiel de données opérationnelles
- Chargement et maintenance d'un entrepôt de données
- Synchronisation des systèmes de business intelligence (BI) et de reporting
- Migration des charges de travail vers une infrastructure cloud
- Consolidation des données de base provenant de systèmes parallèles à la suite d'une fusion ou d'une acquisition
- Intégration de données d'entraînement et d'inférence dans les charges de travail liées à l'IA et à l'analyse de données
Les avantages découlent de ce même principe : chaque unité opérationnelle travaille à partir des mêmes données internes, ces données sont disponibles rapidement, et l'étape d'agrégation permet de définir facilement des indicateurs clés de performance (KPI) valables pour l'ensemble des services.
Étude de cas : migration de 300 000 enregistrements avec X4 BPMS
Un scénario ETL classique consiste à remplacer un système métier central. Les données de l'ancienne version doivent être lues dans leur intégralité, converties au format du nouveau système, puis importées dans celui-ci — sans perdre aucune information pertinente en cours de route, et en veillant à ce que le traitement sémantique soit correctement effectué, et non pas uniquement la conversion de format.
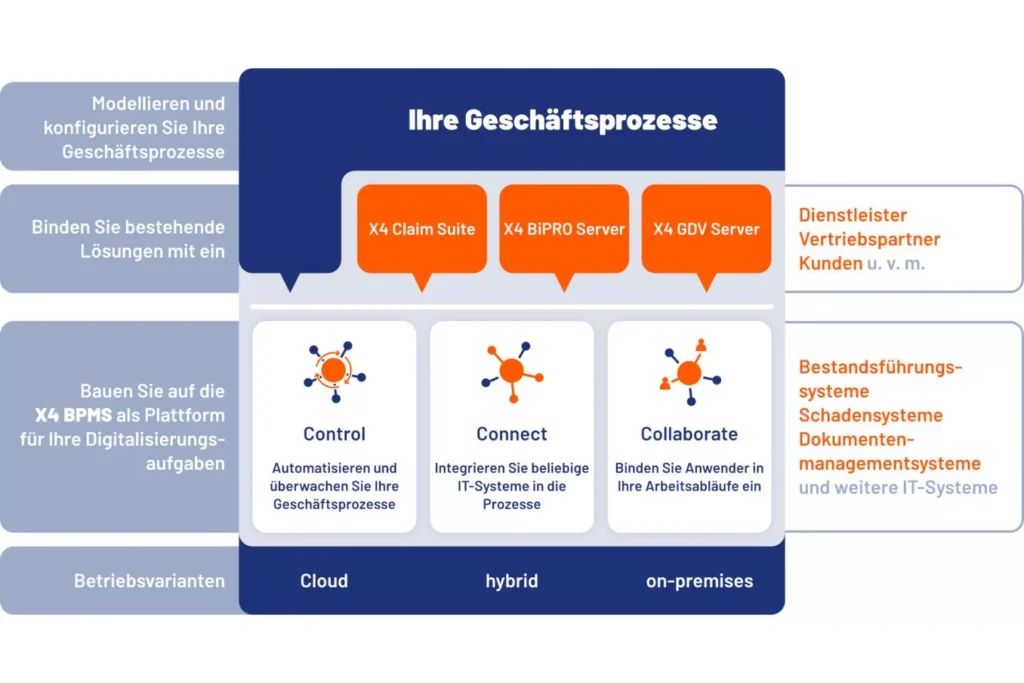
Un client s'est retrouvé confronté à cette situation précise : un nouveau CRM commercial, avec plus de 300 000 fiches clients, contrats et produits à transférer depuis la plateforme existante. Le X4 BPMS a géré ce processus comme suit.
- Extract. Le système source était connecté via un adaptateur — en l'occurrence le connecteur JDBC — afin de pouvoir extraire des données à tout moment. Toutes les données extraites étaient d'abord enregistrées dans une base de données de transfert avant d'être traitées, ce qui garantissait que chaque exécution démarrait à partir d'un état reproductible.
- Transform. Le Mapping Designer intégré à X4 Designer a été utilisé pour modéliser la conversion du format source vers le format cible, en reliant graphiquement les champs pertinents de la structure d'entrée à ceux de la structure cible, plutôt que par le biais de code.
- Load. Un deuxième adaptateur reliait le système cible, permettant ainsi d'importer les données transformées à la demande.
Les composants concernés : X4 Designer, avec son Mapping Designer intégré permettant de modéliser les transformations ; X4 ESB, en tant que serveur exécutant les services techniques ; et les adaptateurs X4 assurant la connexion aux systèmes tiers.
Comme chaque étape intermédiaire est reproductible et que la transformation elle-même s'effectue via une correspondance transparente plutôt que par du code opaque, la migration aboutit à un résultat dont la qualité est garantie. Elle est également facile à réutiliser : les différentes étapes — extraction, transformation ou chargement — peuvent être adaptées ou remplacées sans avoir à reconstruire le pipeline.
Exécution d'un processus ETL sur X4 BPMS
Trois éléments distinguent l'exécution d'un processus ETL sur une plateforme de processus plutôt que sur un produit ETL autonome.
Étendue de la connectivité. X4 BPMS prend en charge un large éventail de sources de données grâce à plus de 200 connecteurs prédéfinis, couvrant les données structurées et non structurées au sein d'environnements hétérogènes. Les services peuvent être exposés et utilisés via la gestion des API lorsque l'intégration doit fonctionner dans les deux sens.
Pipelines et processus réunis dans un seul modèle. Une tâche ETL existe rarement de manière isolée : elle constitue généralement une étape au sein d’un processus métier plus large, assortie de validations, d’une gestion des exceptions et d’actions en aval. La modélisation des deux éléments dans le même environnement permet d’éviter la séparation habituelle entre un outil ETL et un moteur de workflow distinct, qui doivent être synchronisés manuellement.
Visibilité opérationnelle. Les pipelines sont modélisés, surveillés et ajustés via une même interface visuelle, ce qui permet aux utilisateurs ayant moins de connaissances techniques de participer à la conception et à la validation des flux de données, plutôt que de se contenter de créer des tickets. L'intégration d'étapes de nettoyage au sein même du pipeline garantit que seuls les enregistrements dont la qualité a été vérifiée parviennent à leur destination — condition indispensable à toute analyse s'appuyant sur ces données.
Pour avoir une vision d'ensemble du domaine architectural, consultez notre présentation de l'intégration transparente, le guide de choix d'une plateforme d'intégration de données, ainsi que la comparaison entre ESB, middleware et microservices.
Commencez à automatiser vos processus ETL
Si vous prévoyez de mettre en place un processus ETL et que vous recherchez l'outil adapté, le moyen le plus rapide d'évaluer s'il vous convient est de le comparer à vos propres systèmes sources et formats cibles. Nous serons ravis de vous présenter la plateforme en nous basant sur votre cas concret.

En tant que directeur des produits, Édouard Cante est chargé de l'orientation stratégique et du développement du portefeuille de produits de SoftProject. Fort d'une excellente connaissance du marché et d'un esprit d'innovation très marqué, il promeut des solutions centrées sur le client et veille à la compétitivité à long terme de l'entreprise.
Foire aux questions sur les plateformes de données
Qu'est-ce qu'un outil ETL ?
Un outil ETL est un logiciel qui automatise l'extraction des données à partir de systèmes sources, leur transformation dans un format cible cohérent et leur chargement vers une destination telle qu'une base de données ou un entrepôt de données. Il remplace l'extraction manuelle et la création de scripts par des pipelines planifiés, surveillés et reproductibles.
Quelle est la différence entre ETL et ELT ?
Dans le modèle ETL, les données sont transformées avant d'être chargées, de sorte que la cible contient des enregistrements nettoyés et mis en conformité. Dans le modèle ELT, les données brutes sont d'abord chargées, puis transformées uniquement lorsqu'une analyse est lancée. Le modèle ETL convient aux cibles structurées, aux données réglementées et aux migrations de systèmes ; le modèle ELT convient aux volumes importants et aux analyses exploratoires sur un lac de données.
Un outil ETL, est-ce la même chose qu'une plateforme d'intégration de données ?
Non. L'ETL est l'un des modèles d'intégration de données. Une plateforme d'intégration de données couvre également l'échange en temps réel, l'intégration via des API, le streaming d'événements et l'orchestration des processus. Un outil ETL qui ne prend en charge que le chargement par lots ne répondra qu'à une minorité des besoins d'intégration d'un environnement d'entreprise type.
Combien de temps dure une migration ETL ?
L'extraction et le chargement constituent rarement le maillon faible. L'essentiel du travail réside dans la mise en correspondance sémantique — c'est-à-dire s'accorder sur la signification de chaque champ dans l'ancien et le nouvel système — et dans la validation du résultat. La migration de quelques centaines de milliers d'enregistrements se mesure généralement en semaines d'analyse et en jours d'exécution, et non l'inverse.
L'ETL est-il encore nécessaire si l'on dispose d'une intégration en temps réel ?
En général, oui. Le streaming et la capture des données en temps réel (CDC) sont adaptés aux flux pour lesquels la latence est un facteur déterminant ; l'ETL par lots reste quant à lui le choix le plus pratique pour les grands ensembles de données de référence, les rapprochements périodiques et les chargements historiques. La plupart des entreprises utilisent ces deux approches de front à front, plutôt que de remplacer l'une par l'autre.