La plupart des organisations ne souffrent pas d'un manque de données. Elles souffrent d'un manque de consensus à leur sujet. L'ERP détient une version du client, l'CRM une autre, le système de terrain une troisième, et la couche de reporting calcule discrètement la moyenne des trois pour aboutir à un résultat auquel personne ne fait confiance. Chaque nouvelle application aggrave le problème, car chacune d'entre elles s'accompagne de sa propre interface, de son propre cycle de mise à jour et de sa propre conception de ce à quoi doit ressembler un enregistrement.
Une plateforme d’intégration de données est la réponse architecturale à cette dérive. Au lieu de relier les systèmes entre eux une interface à la fois, elle met en place une couche unique et régie à travers laquelle les données circulent, sont transformées, validées et mises à disposition — aux équipes internes, aux partenaires et, de plus en plus, aux systèmes d’IA qui s’appuient désormais sur les données de l’entreprise. Cet article explique ce que fait réellement une plateforme d’intégration de données, en quoi elle se distingue des catégories apparentées qui vous seront présentées lors du même processus d’achat, et à quoi ressemble une plateforme complète lorsque l’intégration, l’automatisation et la gouvernance sont considérées comme un seul et même problème plutôt que comme trois problèmes distincts.
Qu'est-ce qu'une plateforme d'intégration de données ?
Une plateforme d'intégration de données est un logiciel qui relie des systèmes d'entreprise distincts via une couche centrale, afin que les données puissent être échangées, transformées, validées et synchronisées sans avoir à créer une interface dédiée pour chaque paire d'applications. Au lieu que chaque système sache communiquer avec tous les autres, chaque système communique une seule fois avec la plateforme. Celle-ci se charge de la conversion des protocoles, du mappage des champs, de la gestion des erreurs, de la planification et de la surveillance.
C'est cette position centrale qui confère toute sa valeur à cette catégorie et qui donne tout son poids à la décision d'achat. Une plateforme d'intégration de données a accès à tous les enregistrements qui transitent entre les différents systèmes ; elle constitue donc le lieu tout désigné pour appliquer les règles de qualité des données, consigner les modifications apportées et leurs raisons, et offrir aux utilisateurs métier une vue d'ensemble des informations qui, sans cela, resteraient enfermées dans une base de données à laquelle ils n'auraient jamais accès.
Le test pratique est simple. Si l'ajout d'une nouvelle application à votre environnement nécessite actuellement un projet, un développeur et un engagement de maintenance s'étendant sur plusieurs années, vous utilisez une intégration point à point. Si l'ajout d'une nouvelle application se résume à configurer une connexion supplémentaire au sein d'une couche existante, vous utilisez une plateforme d'intégration de données.
Pourquoi l'intégration point à point atteint ses limites en termes d'évolutivité
Les interfaces programmées individuellement constituent presque toujours le bon choix au moment où elles sont mises en place. La première permet de résoudre rapidement un problème concret. La deuxième aussi. La difficulté est d’ordre arithmétique : le nombre de connexions possibles entre les systèmes augmente à peu près proportionnellement au carré du nombre de systèmes ; ainsi, un environnement comptant dix applications peut impliquer des dizaines d’interfaces sur mesure, chacune ayant été développée par une personne qui ne travaille peut-être plus dans l’entreprise.
Ces coûts se manifestent à trois niveaux. Les modifications deviennent coûteuses, car l’ajout d’un simple champ à l’ ERP e se répercute sur toutes les interfaces qui y sont liées. Le diagnostic devient lent, car lorsqu’une synchronisation nocturne échoue, il n’y a pas d’endroit unique où chercher : la défaillance peut se situer dans n’importe lequel d’une douzaine de scripts, chacun générant des journaux de manière différente. Et la confiance s’érode, car les différents systèmes se désynchronisent et l’entreprise apprend peu à peu, en silence, quels chiffres croire et lesquels vérifier manuellement.
Le coût stratégique est bien plus élevé que n'importe lequel de ces éléments. Les projets d'automatisation, les programmes d'analyse et les initiatives d'IA partent tous du principe que les données peuvent être récupérées de manière fiable, quel que soit leur emplacement. Lorsque cette hypothèse s'avère fausse, les projets ambitieux s'enlisent au stade de l'intégration et l'entreprise en conclut qu'elle est confrontée à un problème d'IA, alors qu'il s'agit en réalité d'un problème d'infrastructure.

Les quatre symptômes d'un problème d'intégration
- Silos de données. Les services disposent de données qui se recoupent sans jamais être harmonisées, et l'élaboration de rapports transversaux nécessite une consolidation manuelle.
- Les ruptures de support. Les informations quittent un système sous la forme d'un document, d'un e-mail ou d'une feuille de calcul, puis sont ressaisies dans le système suivant, ce qui entraîne des retards et des erreurs à chaque étape.
- Fragilité des interfaces. Les mises à jour de routine sont reportées, car personne ne sait avec certitude quelles intégrations risquent d'être perturbées.
- État du processus « invisible ». Personne ne peut dire où en est un dossier, une commande ou une demande de connexion sans interroger trois personnes.
Plateforme d'intégration de données, iPaaS, ESB, ETL : quelle est la différence ?
Ces termes se recoupent largement dans les communications marketing des éditeurs, ce qui rend la comparaison des solutions présélectionnées plus difficile qu'elle ne devrait l'être. Les distinctions qui comptent dans la pratique concernent l'environnement d'exécution du logiciel, les données qu'il traite et le fait qu'il exécute ou non une logique métier.
| Catégorie | Emploi principal | Modèle type | Idéal pour |
|---|---|---|---|
| Outils ETL / ELT | Transférer les données par lots vers un entrepôt ou un lac de données à des fins d'analyse | Planifié, unidirectionnel, orienté analyse | Pipelines de reporting et d'analyse décisionnelle |
| Bus de services d'entreprise (ESB) | Acheminer et transformer les messages entre les systèmes opérationnels | Basé sur les événements, bidirectionnel, souvent sur site | Synchronisation opérationnelle en temps réel |
| iPaaS | Proposer l'intégration sous forme de service cloud géré | Basé sur des connecteurs, hébergé dans le cloud, par abonnement | Environnements « cloud-first » avec des points de terminaison SaaS standard |
| Plateforme d'intégration de données | Réunir la connectivité, la transformation, l'orchestration et la gouvernance au sein d'une seule couche | Flexibilité de déploiement ; permet à la fois d'exécuter des processus et de transférer des données | Des environnements hybrides associant des systèmes traditionnels, sur site et dans le cloud |
La limite de catégorie la plus importante est la dernière ligne. Dans la plupart des organisations, le transfert de données entre les systèmes et l’exécution du processus métier qui exploite ces données relèvent d’un même projet : un relevé de compteur entrant n’est utile que s’il déclenche l’étape de facturation qui s’ensuit. Les plateformes qui séparent ces deux éléments vous obligent à acheter et à exploiter un deuxième produit, et à accepter un point de transfert où la responsabilité en cas de défaillance devient ambiguë. Une analyse plus approfondie des cas dans lesquels chaque modèle architectural est approprié est présentée dans notre comparaison entre ESB, middleware et microservices.
Ce qu'une couche d'intégration complète doit faire
Les critères d'achat pour cette catégorie sont souvent exprimés en nombre de connecteurs, ce qui constitue un indicateur peu fiable pour déterminer si une plateforme sera performante dans votre environnement. Voici les fonctionnalités qui déterminent les résultats.
Une connectivité étendue et assurée
Les adaptateurs standard pour les systèmes que vous utilisez réellement — ERP, CRM, GIS, SCADA, la gestion documentaire, les registres sectoriels et la couche « fichiers et protocoles » qui les sous-tend — éliminent la principale source de coûts d’un projet. Ce qui compte, ce n’est pas le chiffre affiché, mais le fait que les systèmes spécifiques de votre environnement soient couverts par des adaptateurs mis à jour, plutôt que par la promesse d’un développement sur mesure.
Transformation sans code écrit à la main
Les données ne se présentent presque jamais sous la forme attendue par le système destinataire. Une plateforme qui gère le mappage, l'enrichissement et la conversion de format via une configuration plutôt que par du code permet aux personnes qui maîtrisent les règles métier d'apporter des modifications, et non plus uniquement aux deux développeurs qui comprennent le script d'origine.
L'exécution des processus, et pas seulement leur transfert
Dans la pratique, l’intégration et l’automatisation vont de pair. Une plateforme capable de modéliser et d’exécuter un processus complet — y compris les branchements conditionnels, les étapes d’approbation humaine, les nouvelles tentatives et les escalades — élimine la rupture entre « l’arrivée des données » et « l’action qui en découle ».
Une gouvernance intégrée, et non pas ajoutée après coup
Une fois que les données transitent par une couche centrale, celle-ci devient le point de référence naturel pour répondre aux questions posées par les auditeurs et les autorités de régulation : d’où provient cette valeur, qui en est responsable, quelles règles lui ont été appliquées et où est-elle encore utilisée ? Intégrer a posteriori la traçabilité dans une couche d’intégration qui n’a jamais été conçue pour l’enregistrer est nettement plus difficile que de choisir une plateforme qui la capture au fur et à mesure que les données circulent.
Transparence opérationnelle
Une couche centrale dépourvue de surveillance centralisée reproduit le problème de diagnostic qu’elle était censée résoudre. C’est la visibilité en temps réel sur les processus en cours d’exécution, les transferts ayant échoué et le débit qui permet à une plateforme d’intégration de passer du statut d’infrastructure à celui d’un service dont les niveaux de service peuvent être exigés par l’entreprise.
Comment la plateforme SoftProject offre une vision globale
SoftProject considère l'intégration comme une composante d'une plateforme connectée plutôt que comme un produit autonome, car les organisations qui rencontrent des difficultés en matière d'intégration sont presque toujours confrontées, en parallèle, à des problèmes d'automatisation et de gouvernance, et ce pour la même raison sous-jacente.
X4 BPMS — intégration et automatisation de bout en bout
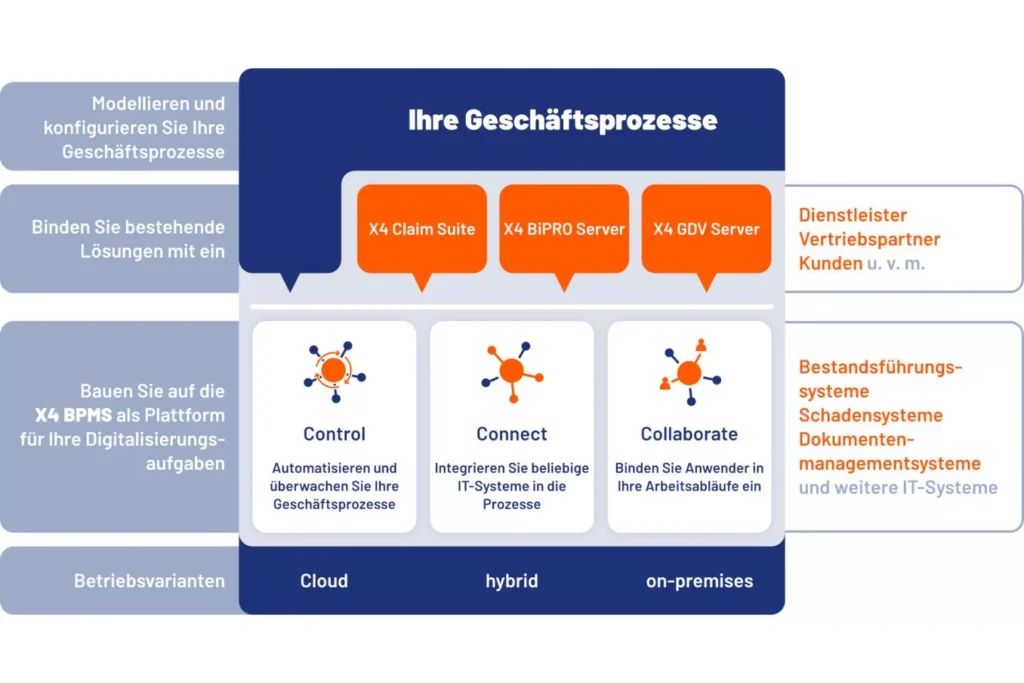
X4 BPMS est la plateforme « low-code » au cœur de l’architecture. Son Enterprise Service Bus relie les systèmes sources et cibles via plus de 200 adaptateurs standard, synchronisant les enregistrements entre les applications connectées et les mettant à jour à mesure qu’ils évoluent. Comme cette même plateforme modélise les processus en BPMN 2.0, la couche d’intégration et la logique métier qui l’utilise sont développées, versionnées et surveillées conjointement. L’ Process Monitor offre aux équipes opérationnelles une vue en temps réel de chaque instance en cours d’exécution, tandis que l’environnement de modélisation graphique permet aux responsables de processus d’ajuster les flux sans passer par un cycle de développement. C’est ce qui permet concrètement à un environnement composé de systèmes hérités et modernes de fonctionner comme un tout, et c’est pourquoi la plateforme est déployée dans les secteurs des services publics, de la finance, de l’assurance, de la santé, de l’industrie et du secteur public.


Phoenix — gouvernance de l'intégration et de l'exécution
Phoenix répond à la question qui se pose dès lors que l'intégration fonctionne à grande échelle : qui décide de ce qui est exécuté, selon quelles règles, et comment cette décision est-elle justifiée ? Il assure la gouvernance de l'intégration et de l'exécution au sein de l'entreprise, afin que les flux de données restent contrôlés et vérifiables à mesure que le nombre de systèmes connectés et de processus automatisés augmente.
dataspot. — gouvernance des données et traçabilité axées sur l'entreprise
dataspot. décrit les données en termes métier plutôt qu’en termes techniques. Il recense les définitions, la propriété, les relations et la traçabilité, ce qui transforme la couche d’intégration, qui n’est plus un simple ensemble de canaux, en un modèle documenté illustrant la manière dont l’information circule au sein de l’organisation. C’est ce composant qui apporte les réponses aux questions réglementaires concernant l’origine et la responsabilité, et c’est ce qui fait de la gestion des données de référence une discipline encadrée plutôt qu’un simple exercice de nettoyage périodique.
MyDataCatalogue — exploration de l'ensemble du paysage
MyDataCatalogue permet d'effectuer des recherches dans l'ensemble des données connectées. Les analystes, les gestionnaires de données et les utilisateurs métier peuvent ainsi identifier les ensembles de données existants, comprendre leur signification et déterminer qui en est responsable, sans avoir à ouvrir de ticket. Alors que les systèmes d'IA exploitent de plus en plus directement les données d'entreprise, un catalogue régulièrement mis à jour devient le mécanisme qui permet de déterminer si ces systèmes s'appuient sur des sources contrôlées ou sur des données trouvées au hasard.
Pourquoi l'intégration des données est désormais une condition préalable à l'IA
La vague actuelle d'IA d'entreprise a bouleversé la dynamique économique de l'intégration. La fiabilité des modèles linguistiques et des systèmes agents dépend entièrement des données auxquelles ils ont accès, et ils ne sont pas en mesure de pallier les divergences entre trois systèmes concernant un même client. Alimenter un modèle à partir d'un environnement fragmenté génère des réponses « sûres » fondées sur des données incohérentes, ce qui constitue un mode de défaillance bien plus grave que l'absence totale de réponse.
Une couche d’intégration régie par des règles change la donne. Lorsque les enregistrements sont synchronisés, que les transformations sont documentées, que la traçabilité est assurée et qu’un catalogue décrit la signification de chaque ensemble de données, les systèmes d’IA peuvent être orientés vers des sources dont on sait qu’elles sont à jour et dont on connaît le propriétaire. Les organisations qui progressent le plus rapidement dans la mise en œuvre de l’IA sont, à quelques exceptions près, celles qui ont d’abord résolu les questions liées à leur couche d’intégration et de gouvernance — non pas parce que l’intégration est plus intéressante, mais parce que c’est l’étape incontournable.
Données de référence cohérentes
La synchronisation permet d'assurer la cohérence entre les systèmes connectés, évitant ainsi à chaque service de gérer sa propre copie.
Les résultats mesurables sont identiques dans tous les secteurs d’activité. Les données de référence ne sont plus dupliquées, car un processus de synchronisation unique assure la cohérence entre les systèmes connectés, évitant ainsi à chaque service de gérer sa propre copie. L’adoption de nouvelles applications devient moins coûteuse, car l’intégration d’un système se résume à configurer une connexion plutôt qu’à lancer un projet. Le reporting s’améliore, car les informations issues de bases de données propriétaires peuvent être affichées dans des tableaux de bord sans passer par le rituel habituel d’exportation et de rapprochement. Et la transparence des processus en est une retombée directe, car une couche qui achemine chaque transaction permet également de visualiser où chacune d’entre elles se trouve à un moment donné.
Pour les organisations en contact direct avec la clientèle, cela a une autre conséquence. Les partenaires et les clients peuvent se voir accorder un accès contrôlé aux données qui les concernent — relevés de facturation, séries chronologiques, données de référence — via la même couche régie qui dessert les utilisateurs internes, plutôt que via un portail distinct géré en parallèle. Le modèle associé de consolidation des dossiers clients fragmentés est abordé dans notre article consacré à la « vue unique du client » et à la « fiche de référence ».
Choisir une plateforme d'intégration de données : cinq questions
- Est-ce que cela couvre nos systèmes actuels ? Demandez la liste des adaptateurs correspondant à votre parc, y compris les systèmes hérités dont personne ne veut parler.
- Peut-il fonctionner sur site, dans le cloud ou les deux ? Les environnements hybrides et les exigences en matière de souveraineté des données excluent les outils exclusivement basés sur le cloud plus souvent que ne le pensent les acheteurs.
- Peut-elle exécuter des processus, ou se contente-t-elle de transférer des données ? Si ce n'est pas le cas, prévoyez un budget pour une deuxième plateforme et déterminez qui est responsable de la délimitation entre les deux.
- Qui peut modifier une intégration ? Si la réponse est « uniquement les développeurs », les coûts de maintenance suivront la même courbe que celle de l'architecture point à point que vous remplacez.
- Quelles informations enregistre-t-elle ? Il est bien moins coûteux d'intégrer l'historique de la provenance, des changements de propriété et des audits en tant que fonctionnalité native de la plateforme plutôt que de le faire dans le cadre d'un projet ultérieur.
Regrouper vos systèmes au sein d'une couche unique et régie par des règles
La dette d’intégration se distingue des autres problèmes techniques en ce qu’elle déclenche rarement une crise. Les interfaces continuent de fonctionner, les solutions de contournement deviennent des habitudes, et le coût reste réparti entre toutes les équipes sous forme de légers retards et de rapprochements manuels. Elle n’apparaît au grand jour que lorsqu’un projet ambitieux est entrepris — un programme d’automatisation, une échéance réglementaire, une initiative d’IA — et que le parc informatique s’avère incapable de le prendre en charge.
SoftProject a mené à bien des projets d’intégration et d’automatisation pour plus de 300 organisations issues de secteurs réglementés et caractérisés par une grande complexité opérationnelle. Si vous vous demandez si votre environnement a besoin d’une plateforme d’intégration de données, le moyen le plus rapide de le savoir est de suivre de bout en bout un processus réel avec quelqu’un qui a déjà rencontré ce type de situation.
Réservez une démonstration pour découvrir comment X4 BPMS, Phoenix, dataspot. et MyDataCatalogue fonctionnent ensemble au sein de vos systèmes.